所悟 · 2026-09-26
音视频转文本解决方案:Whisper
试用了几个在线的,如:飞书妙记、腾讯会议转写等,有个问题就是免费时长有限,超出需付费,API类的更不用说了,于是试了下开源的本地模型。
音视频转文本解决方案:Whisper
前段时间,我尝试把几期播客内容整理成公众号文章。
试用了几个在线的,如:飞书妙记、腾讯会议转写等,有个问题就是免费时长有限,超出需付费,API类的更不用说了,于是试了下开源的本地模型。
过程比我想象得更有意思——也更“技术”。
音频转文字这件事,听起来简单,但真正上手之后才发现:
工具选择不同,效率差异巨大。 部署方式不同,成本结构完全不同。 使用场景不同,答案也不同。
这篇文章,我把自己的实践和思考做一次系统整理。
为什么“音视频转文字”越来越重要?
我们正处在一个声音爆炸的时代。
播客、视频、访谈、线上会议、课程回放…… 大量优质内容都以“声音”的形式存在。
但声音有一个天然缺陷:
它不可搜索、不可快速扫描、不可结构化。
文字则完全相反。
当一段 60 分钟的播客被转成文字:
- 可以 Ctrl+F 搜索
- 可以拆分结构
- 可以提炼观点
- 可以改写成文章
- 可以沉淀为知识资产
语音识别的本质,不是“把声音变成字”。
而是把时间型信息,变成结构型信息。
这就是它真正的价值。
在线工具 vs 本地部署
目前主流方案大致分为两类:
1️⃣ 在线工具
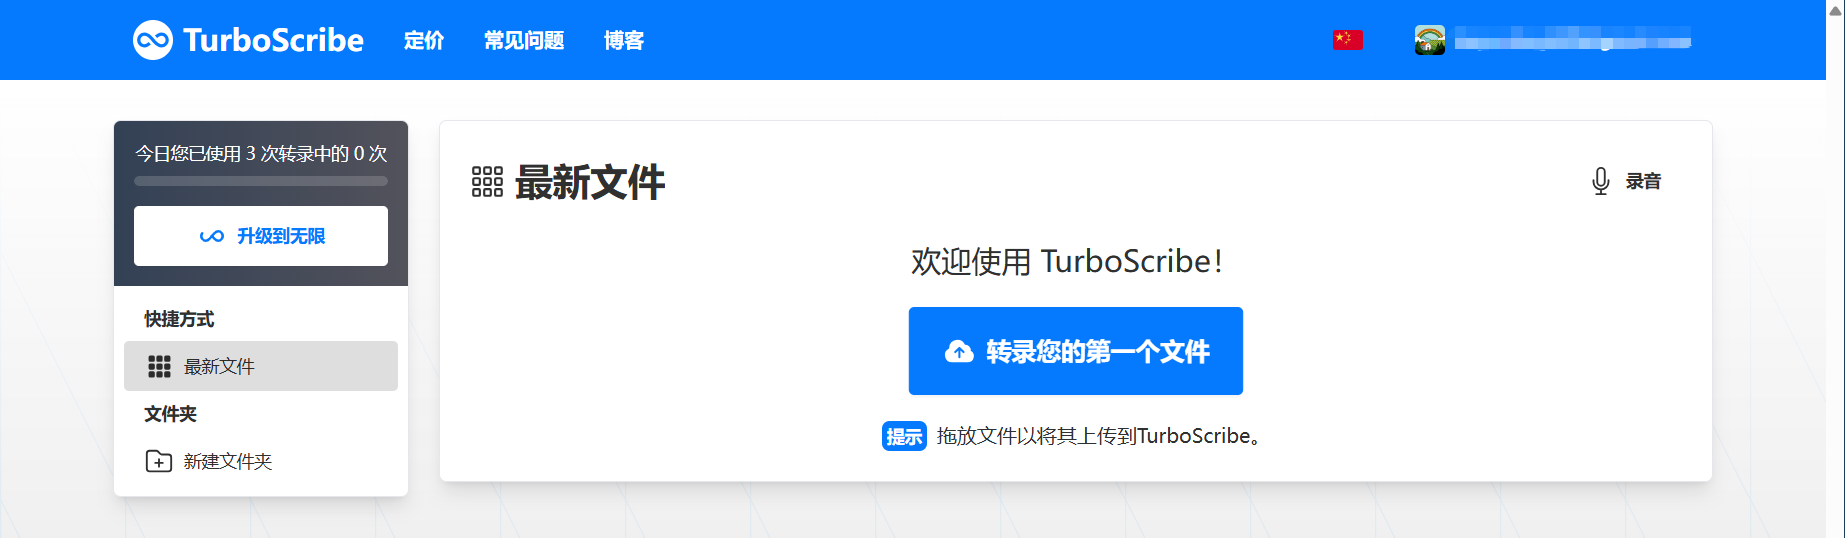
典型代表:
- turboscribe.ai
- 飞书妙记
- 腾讯会议转写
- Notta 等 SaaS 工具
优点:
- 无需配置
- 上传即可使用
- 界面友好
- 支持导出
缺点:
- 免费时长有限(常见 30~60 分钟)
- 长音频可能需要付费
- 数据上传到第三方服务器
适合:
- 偶尔使用
- 不想折腾技术
- 会议纪要场景
2️⃣ 本地部署方案
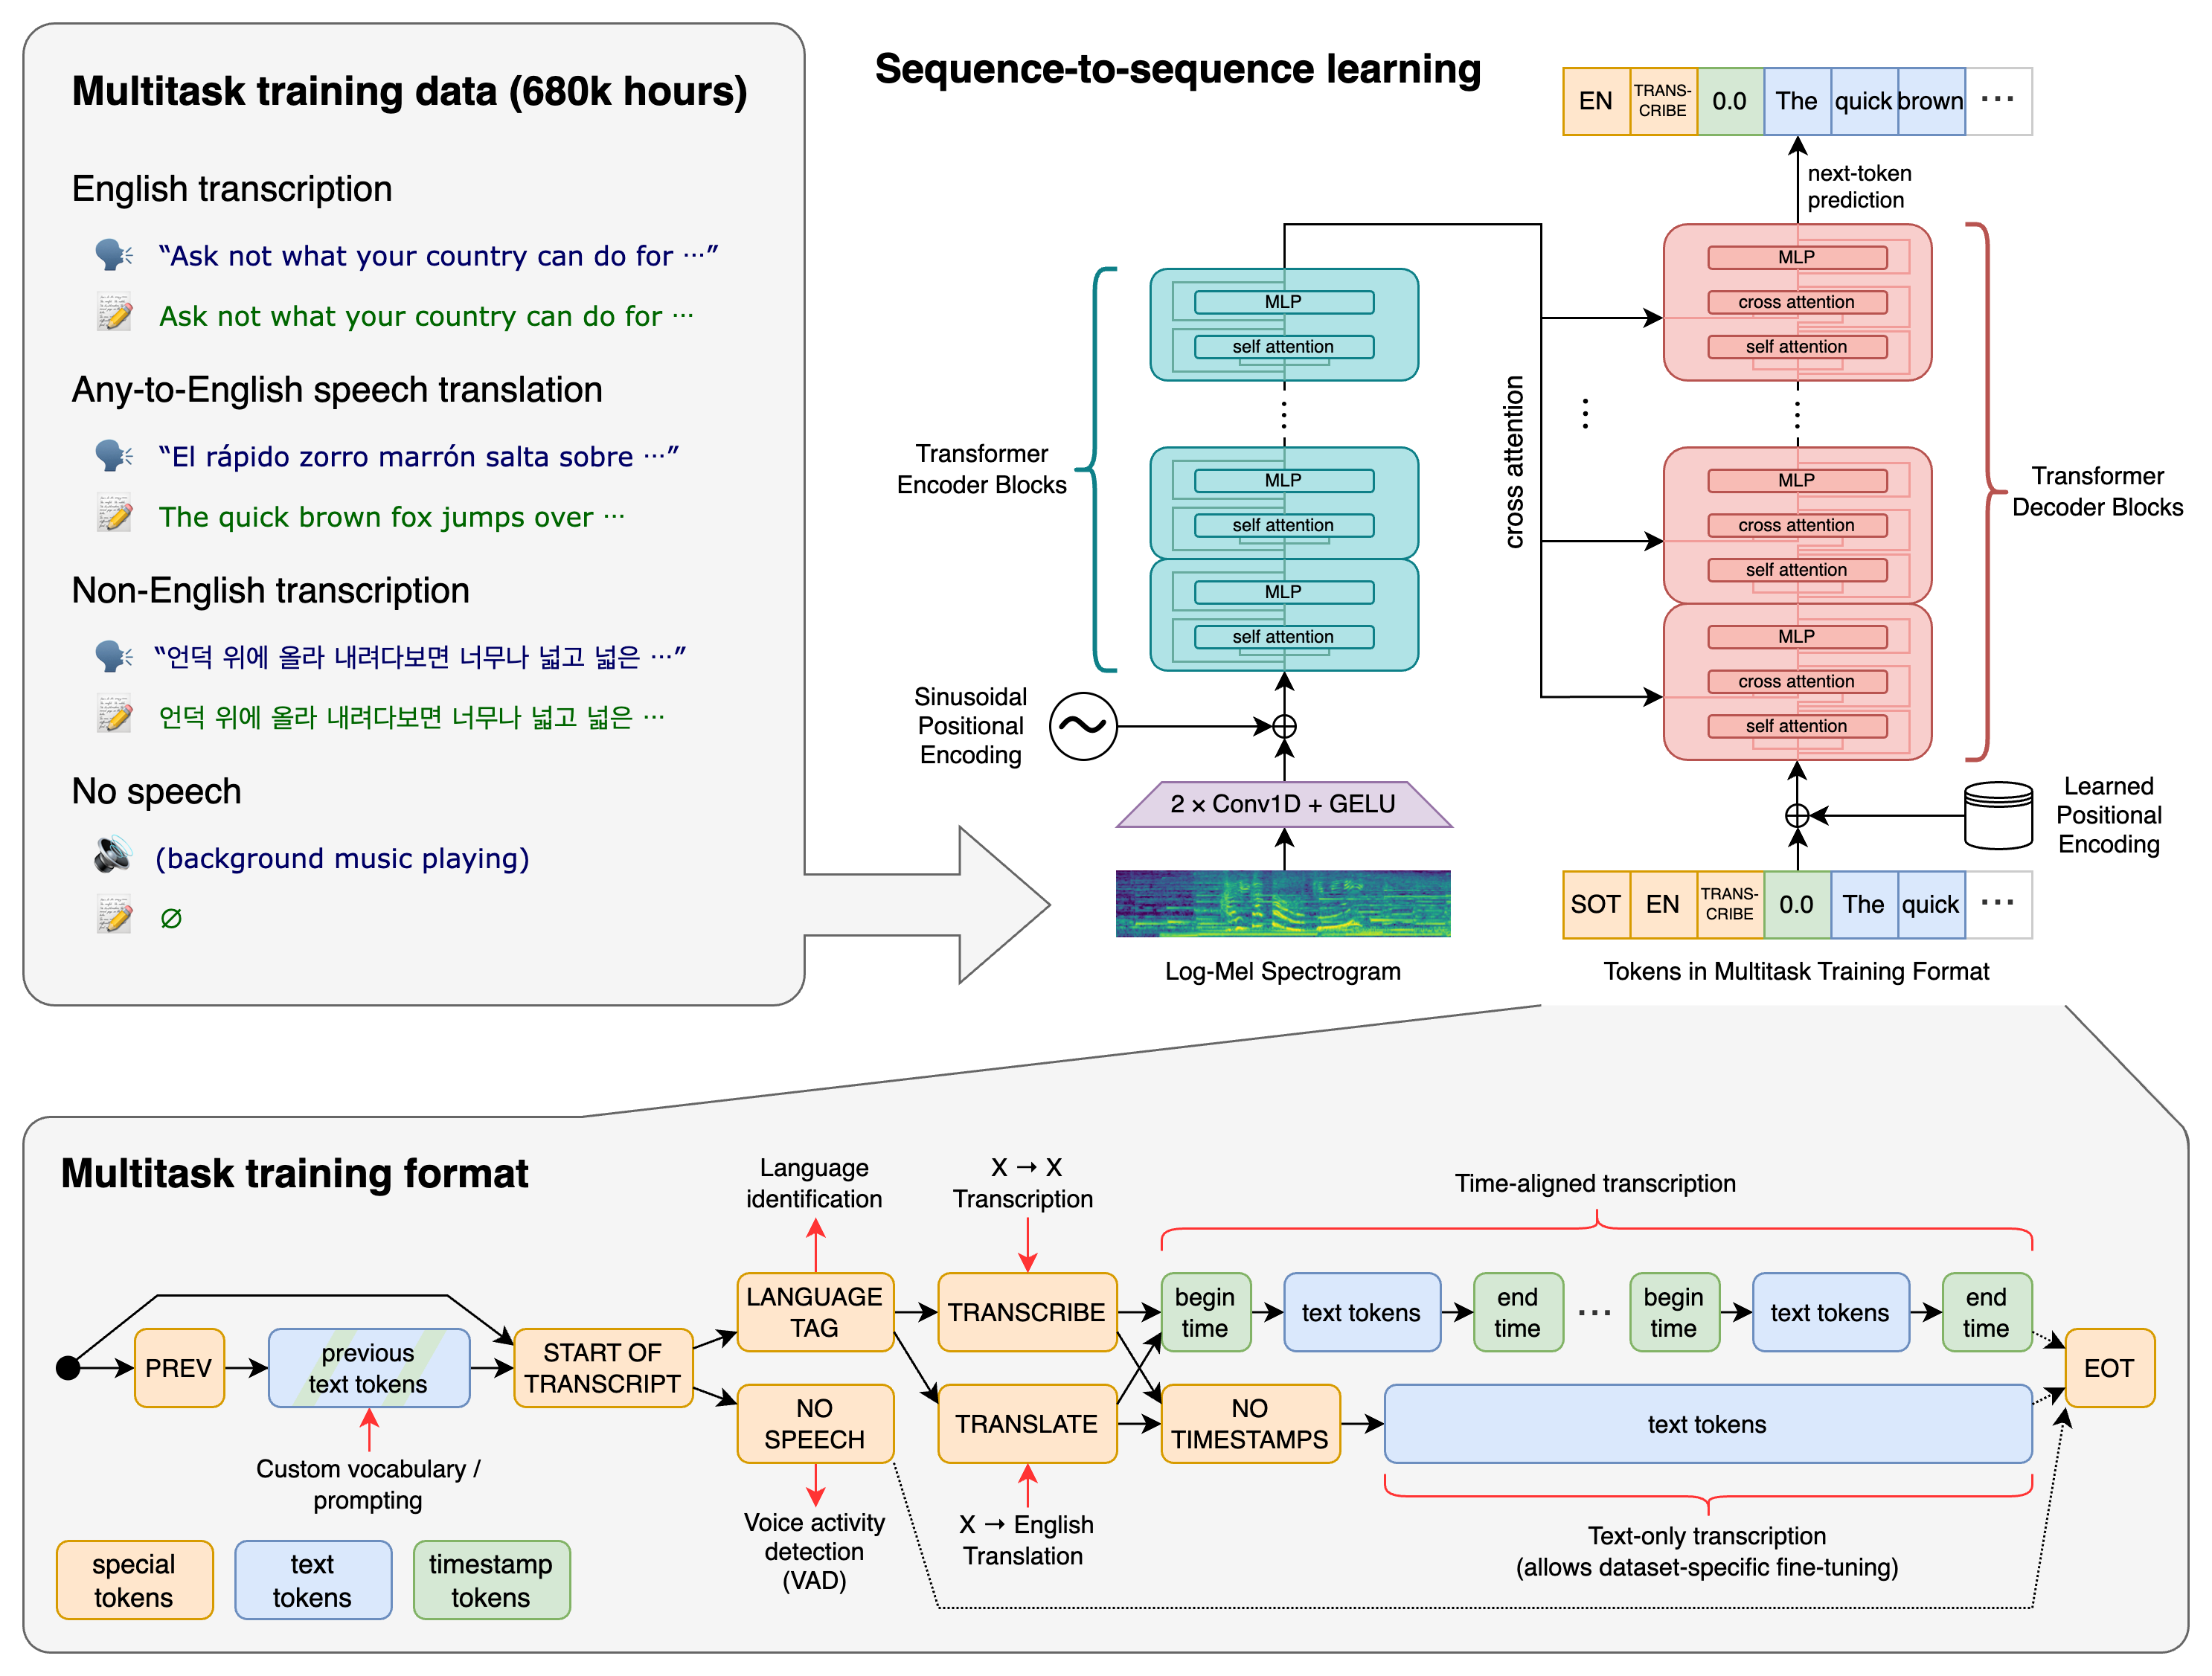
核心模型: Whisper
以及它的高性能实现: faster-whisper
优点:
- 完全免费
- 无时长限制
- 数据不外传
- 可批量自动化
缺点:
- 需要安装环境
- CPU 下速度较慢
- 需要一定技术基础
如果你长期处理播客、视频素材,本地部署几乎是性价比最高的选择。
尤其是 faster-whisper + int8 量化,在纯 CPU 环境下也能显著提速。
功能比对
| 工具名称 | 类型 | 是否免费 | 时长限制 | 中文识别准确率 | 是否需显卡 | 适合人群 |
|---|---|---|---|---|---|---|
| OpenAI Whisper(原版) | 本地开源 | 免费 | 无限制 | ⭐⭐⭐⭐☆ | 建议GPU | 技术用户、数据安全要求高 |
| faster-whisper | 本地加速版 | 免费 | 无限制 | ⭐⭐⭐⭐☆ | 不必须 | CPU用户、追求效率 |
| 飞书妙记 | 在线工具 | 部分免费 | 免费一般30-60分钟 | ⭐⭐⭐⭐ | 否 | 办公人群、播客整理 |
| 腾讯会议转写 | 在线工具 | 部分免费 | 免费时长有限 | ⭐⭐⭐⭐ | 否 | 会议整理、团队协作 |
| Alibaba Cloud 语音识别 | 云API | 按量付费 | 无明显限制 | ⭐⭐⭐⭐☆ | 否 | 企业集成开发 |
| Tencent Cloud 语音识别 | 云API | 按量付费 | 无明显限制 | ⭐⭐⭐⭐☆ | 否 | 企业系统对接 |
| Notta.ai | 在线网站 | 部分免费 | 免费时长有限 | ⭐⭐⭐⭐ | 否 | 非技术用户 |
| WhisperX | 本地增强 | 免费 | 无限制 | ⭐⭐⭐⭐⭐ | 建议GPU | 专业字幕制作 |
不同人群怎么选?
这个问题不能一刀切。
如果你是普通办公用户
直接用在线工具。 你的时间比折腾环境更值钱。
如果你是内容创作者
建议:
- 在线工具做应急
- 本地部署做长期
因为一旦你形成“音频 → 文字 → 文章”的固定流程,本地方案会更稳定。
如果你是技术用户
推荐直接搭建:
- ffmpeg(音视频解码)
- Whisper / faster-whisper
- Python 自动化脚本
- 批量导出 txt / srt / json
这是一条完整的内容生产流水线。
我的推荐方案
结合实践,我的选择是:
短内容 → 在线工具 长内容 / 批量处理 → faster-whisper 本地部署
原因很简单:
在线工具解决“偶尔需求”。 本地部署解决“系统需求”。
我甚至写了一个:
- 自动检测环境脚本
- 自动修复依赖
- 支持进度条
- 自动导出时间戳文本
- 同时生成 srt / json / csv
当工具链准备好之后,流程会变得非常顺滑:
视频 / 音频
- → 自动转写
- → 自动生成带时间戳文本
- → 二次加工成公众号文章
机器负责听。 人负责思考。
本地部署
已经写好了脚本,能自动检测并修复组件,根据提示输入需要转写的音视频文件即可。
将以下代码保存为.py文件执行即可(当然,你得装python啊。。[汗])
安装Python:
-
Python下载地址:https://www.python.org/downloads/ 安装时记得勾选:
☑ Add Python to PATH -
也可以使用命令安装(
PowerShell里直接执行:):
winget install -e --id Python.Python.3.15
本地部署代码:
import os
import sys
import time
import json
import csv
import subprocess
import shutil
from datetime import datetime


# -------------------------
# 小工具
# -------------------------
def println(msg=""):
    print(msg, flush=True)


def run(cmd):
    p = subprocess.run(cmd, capture_output=True, text=True)
    return p.returncode, (p.stdout or "").strip(), (p.stderr or "").strip()


def which(exe):
    return shutil.which(exe)


def pip_install(packages, extra_args=None):
    extra_args = extra_args or []
    cmd = [sys.executable, "-m", "pip", "install", "-U"] + extra_args + packages
    println(f"  > 执行:{' '.join(cmd)}")
    code, out, err = run(cmd)
    if code != 0:
        println("  ! 安装失败输出:")
        if out:
            println(out)
        if err:
            println(err)
    return code == 0


def try_import(module_name):
    try:
        __import__(module_name)
        return True, None
    except Exception as e:
        return False, repr(e)


def fmt_ts(seconds: float) -> str:
    if seconds is None:
        return "00:00:00.000"
    ms = int(round(float(seconds) * 1000))
    total = ms // 1000
    h = total // 3600
    m = (total % 3600) // 60
    s = total % 60
    milli = ms % 1000
    return f"{h:02d}:{m:02d}:{s:02d}.{milli:03d}"


def srt_ts(seconds: float) -> str:
    return fmt_ts(seconds).replace(".", ",")


def ffprobe_duration(path: str):
    if not which("ffprobe"):
        return None
    code, out, err = run([
        "ffprobe", "-v", "error",
        "-show_entries", "format=duration",
        "-of", "default=noprint_wrappers=1:nokey=1",
        path
    ])
    if code != 0:
        return None
    try:
        return float(out.strip())
    except Exception:
        return None


def ensure_ffmpeg_windows_best_effort():
    # 只做 best-effort:有 winget/choco 就尝试,没有就提示手装
    if which("ffmpeg") and which("ffprobe"):
        return True

    println("  - 未检测到 ffmpeg/ffprobe 或不完整,尝试自动安装(best-effort)...")

    if which("winget"):
        println("  - 使用 winget 安装 FFmpeg(可能需要管理员权限)")
        code, out, err = run(["winget", "install", "-e", "--id", "Gyan.FFmpeg"])
        if code == 0 and which("ffmpeg") and which("ffprobe"):
            return True

    if which("choco"):
        println("  - 使用 choco 安装 FFmpeg(可能需要管理员权限)")
        code, out, err = run(["choco", "install", "ffmpeg", "-y"])
        if code == 0 and which("ffmpeg") and which("ffprobe"):
            return True

    println("  ! 自动安装 ffmpeg 未成功。请手动安装后重开终端:")
    println("    A) winget install -e --id Gyan.FFmpeg")
    println("    B) choco install ffmpeg -y")
    println("    C) 下载 zip 解压,把 bin 加入 PATH")
    return False


def detect_gpu():
    # 用 torch 判断最稳
    ok, err = try_import("torch")
    if not ok:
        return False, "torch 未安装"
    import torch  # type: ignore
    try:
        return bool(torch.cuda.is_available()), None
    except Exception as e:
        return False, repr(e)


# -------------------------
# 1) 环境检测 + 自动安装
# -------------------------
def ensure_env():
    println("========== 1) 环境检测 ==========")

    # pip 升级
    println("[检查] pip ...")
    pip_install(["pip"])

    # ffmpeg
    println("[检查] ffmpeg/ffprobe ...")
    if os.name == "nt":
        ff_ok = ensure_ffmpeg_windows_best_effort()
    else:
        # 非 Windows:只检测,不自动装(避免 sudo 交互混乱)
        ff_ok = bool(which("ffmpeg")) and bool(which("ffprobe"))
        if not ff_ok:
            println("  ! 未检测到 ffmpeg/ffprobe。请用系统包管理器安装:")
            println("    Linux: sudo apt install ffmpeg  或 sudo dnf install ffmpeg")
            println("    macOS: brew install ffmpeg")

    # torch(用于 GPU 检测;CPU 机器也能装 CPU 版)
    println("[检查] torch ...")
    ok, err = try_import("torch")
    if not ok:
        println("  - 未安装 torch,开始安装 CPU 版 torch ...")
        # CPU torch 安装(官方 CPU 源)
        pip_install(["torch"], extra_args=["--index-url", "https://download.pytorch.org/whl/cpu"])
        ok, err = try_import("torch")
        if not ok:
            println(f"  ! torch 仍无法导入:{err}")
            println("    你可以手动再试:python -m pip install torch --index-url https://download.pytorch.org/whl/cpu")

    # openai-whisper(GPU 用)
    println("[检查] openai-whisper ...")
    ok, err = try_import("whisper")
    if not ok:
        println("  - 未安装 openai-whisper,开始安装 ...")
        pip_install(["openai-whisper"])
        ok, err = try_import("whisper")
        if not ok:
            println(f"  ! openai-whisper 导入失败:{err}")

    # faster-whisper(CPU 用)
    println("[检查] faster-whisper ...")
    ok_fw, err_fw = try_import("faster_whisper")
    if not ok_fw:
        println("  - 未安装 faster-whisper,开始安装 ...")
        pip_install(["faster-whisper"])
        ok_fw, err_fw = try_import("faster_whisper")

    # Windows 常见:装了但 DLL load failed -> 尝试重装二进制依赖
    if os.name == "nt":
        if not ok_fw:
            println(f"  ! faster-whisper 导入失败:{err_fw}")
            println("  - Windows 常见二进制依赖问题,尝试重装 ctranslate2 / av ...")
            pip_install(["ctranslate2"], extra_args=["--force-reinstall"])
            pip_install(["av"], extra_args=["--force-reinstall"])
            ok_fw, err_fw = try_import("faster_whisper")
            if not ok_fw:
                println(f"  ! 仍失败:{err_fw}")
                println("    可能缺 VC++ 运行库(2015-2022 x64)。装一次通常就好。")

    println("---------- 检测结果 ----------")
    println(f"ffmpeg/ffprobe:{'OK' if (which('ffmpeg') and which('ffprobe')) else '缺失/不完整'}")
    println(f"torch:{'OK' if try_import('torch')[0] else 'FAIL'}")
    println(f"openai-whisper:{'OK' if try_import('whisper')[0] else 'FAIL'}")
    println(f"faster-whisper:{'OK' if try_import('faster_whisper')[0] else 'FAIL'}")
    println("--------------------------------")

    return True


# -------------------------
# 2) 交互输入文件路径
# -------------------------
def ask_media_path():
    println("========== 2) 输入需转写的音/视频文件路径 ==========")
    while True:
        path = input("请输入文件完整路径(可拖拽到终端): ").strip().strip('"')
        if os.path.exists(path) and os.path.isfile(path):
            return path
        println("路径无效或文件不存在,请重新输入。")


# -------------------------
# 3) 自动选引擎并转写(带进度 + 时间戳)
# -------------------------
def transcribe_auto(path: str):
    println("========== 3) 自动选择引擎并开始转写 ==========")
    duration = ffprobe_duration(path)
    if duration:
        println(f"[信息] 媒体时长≈ {duration/60:.2f} 分钟(ffprobe)")
    else:
        println("[信息] 无法获取媒体总时长(缺 ffprobe 或解析失败),进度将降级显示。")

    has_gpu, gpu_err = detect_gpu()
    if has_gpu:
        println("[检测] 检测到 GPU(CUDA 可用),将使用 openai-whisper 进行转写。")
        engine = "openai-whisper"
        result = transcribe_with_openai_whisper(path)
    else:
        println("[检测] 未检测到 GPU,将使用 faster-whisper(CPU 更快)进行转写。")
        if gpu_err:
            println(f"[补充] GPU 检测信息:{gpu_err}")
        engine = "faster-whisper"
        result = transcribe_with_faster_whisper(path, duration)

    result["engine"] = engine
    return result


def transcribe_with_faster_whisper(path: str, duration: float | None):
    from faster_whisper import WhisperModel

    # 你可以按需调整:base / small / medium
    model_name = "medium"
    device = "cpu"
    compute_type = "int8"
    language = "zh"

    println(f"[faster-whisper] model={model_name} device={device} compute_type={compute_type} language={language}")
    t0 = time.time()

    model = WhisperModel(model_name, device=device, compute_type=compute_type)
    segments, info = model.transcribe(path, language=language, beam_size=5, vad_filter=True)

    # faster-whisper 一般会带 duration
    dur = getattr(info, "duration", None) or duration
    rows = []
    full_text_parts = []

    last_print = 0.0
    seg_count = 0

    for seg in segments:
        seg_count += 1
        st = float(seg.start)
        ed = float(seg.end)
        text = (seg.text or "").strip()
        full_text_parts.append(text)

        rows.append({
            "index": seg_count,
            "start": st,
            "end": ed,
            "start_ts": fmt_ts(st),
            "end_ts": fmt_ts(ed),
            "text": text,
        })

        if dur:
            now = time.time()
            if now - last_print > 0.5:
                progress = min(ed / dur, 1.0) * 100
                elapsed = now - t0
                eta = (elapsed / (ed / dur) - elapsed) if ed > 0 else 0
                print(f"\r[进度] {progress:6.2f}%  段落={seg_count}  已用时={elapsed:6.1f}s  预计剩余≈{eta:6.1f}s", end="")
                last_print = now

    if dur:
        print("\r[进度] 100.00%  转写完成" + " " * 40)

    elapsed = time.time() - t0
    return {
        "model": model_name,
        "language": language,
        "duration_s": dur,
        "elapsed_s": round(elapsed, 3),
        "segments": rows,
        "text": "\n".join(full_text_parts).strip(),
    }


def transcribe_with_openai_whisper(path: str):
    import whisper

    # GPU 有就用大一点模型更值
    model_name = "large-v2"
    language = "zh"

    println(f"[openai-whisper] model={model_name} language={language}")
    println("[阶段] 1/3 加载模型 ...")
    t0 = time.time()
    model = whisper.load_model(model_name)

    println("[阶段] 2/3 执行转写(openai-whisper 原版无实时进度回调,此处需等待)...")
    # fp16 在 GPU 下通常更快
    result = model.transcribe(path, language=language, fp16=True, verbose=False)

    println("[阶段] 3/3 整理结果并准备导出 ...")
    segments = result.get("segments", [])
    rows = []
    for i, seg in enumerate(segments, start=1):
        st = float(seg.get("start", 0.0))
        ed = float(seg.get("end", 0.0))
        text = (seg.get("text") or "").strip()
        rows.append({
            "index": i,
            "start": st,
            "end": ed,
            "start_ts": fmt_ts(st),
            "end_ts": fmt_ts(ed),
            "text": text,
        })
        if i % 60 == 0:
            p = i / max(len(segments), 1) * 100
            print(f"\r[导出进度] {p:6.2f}%  段落={i}/{len(segments)}", end="")

    if segments:
        print("\r[导出进度] 100.00%  整理完成" + " " * 40)

    elapsed = time.time() - t0
    return {
        "model": model_name,
        "language": language,
        "duration_s_est": float(segments[-1].get("end", 0.0)) if segments else None,
        "elapsed_s": round(elapsed, 3),
        "segments": rows,
        "text": (result.get("text") or "").strip(),
    }


# -------------------------
# 4) 选择导出格式并导出到原目录
# -------------------------
def ask_export_formats():
    println("========== 4) 选择导出格式 ==========")
    println("可选格式:1) txt(带时间戳)  2) srt  3) json  4) csv  5) 全部")
    while True:
        choice = input("请输入序号(1/2/3/4/5): ").strip()
        if choice in {"1", "2", "3", "4", "5"}:
            return choice
        println("输入无效,请重新输入。")


def export_result(media_path: str, result: dict, choice: str):
    folder = os.path.dirname(os.path.abspath(media_path))
    base = os.path.splitext(os.path.basename(media_path))[0]
    engine = result.get("engine", "engine")
    stamp = datetime.now().strftime("%Y%m%d_%H%M%S")
    prefix = os.path.join(folder, f"{base}.{engine}.{stamp}")

    segments = result.get("segments", [])
    full_text = result.get("text", "")

    outputs = {}

    def export_txt():
        path = prefix + ".txt"
        with open(path, "w", encoding="utf-8") as f:
            for row in segments:
                f.write(f"[{row['start_ts']} - {row['end_ts']}] {row['text']}\n")
        outputs["txt"] = path

    def export_srt():
        path = prefix + ".srt"
        with open(path, "w", encoding="utf-8") as f:
            for row in segments:
                i = row["index"]
                f.write(f"{i}\n")
                f.write(f"{srt_ts(row['start'])} --> {srt_ts(row['end'])}\n")
                f.write(f"{row['text']}\n\n")
        outputs["srt"] = path

    def export_json():
        path = prefix + ".json"
        payload = {
            "exported_at": datetime.now().isoformat(timespec="seconds"),
            "meta": {k: v for k, v in result.items() if k not in {"segments", "text"}},
            "segments": segments,
            "text": full_text,
        }
        with open(path, "w", encoding="utf-8") as f:
            json.dump(payload, f, ensure_ascii=False, indent=2)
        outputs["json"] = path

    def export_csv():
        path = prefix + ".csv"
        with open(path, "w", encoding="utf-8", newline="") as f:
            writer = csv.DictWriter(f, fieldnames=["index", "start", "end", "start_ts", "end_ts", "text"])
            writer.writeheader()
            writer.writerows(segments)
        outputs["csv"] = path

    println("[导出] 正在导出文件 ...")
    if choice == "1":
        export_txt()
    elif choice == "2":
        export_srt()
    elif choice == "3":
        export_json()
    elif choice == "4":
        export_csv()
    else:
        export_txt()
        export_srt()
        export_json()
        export_csv()

    println("[导出] 完成 ✅ 输出文件如下:")
    for k, v in outputs.items():
        println(f"  - {k}: {v}")
    return outputs


def main():
    println("======================================")
    println(" 音/视频转文字一键脚本(中文交互版)")
    println("======================================")
    ensure_env()
    media_path = ask_media_path()
    result = transcribe_auto(media_path)
    println("--------------------------------------")
    println(f"[完成] 转写完成,用时 {result.get('elapsed_s')} 秒,模型 {result.get('model')},引擎 {result.get('engine')}")
    println("--------------------------------------")
    choice = ask_export_formats()
    export_result(media_path, result, choice)
    println("全部流程结束 ✅")


if __name__ == "__main__":
    main()
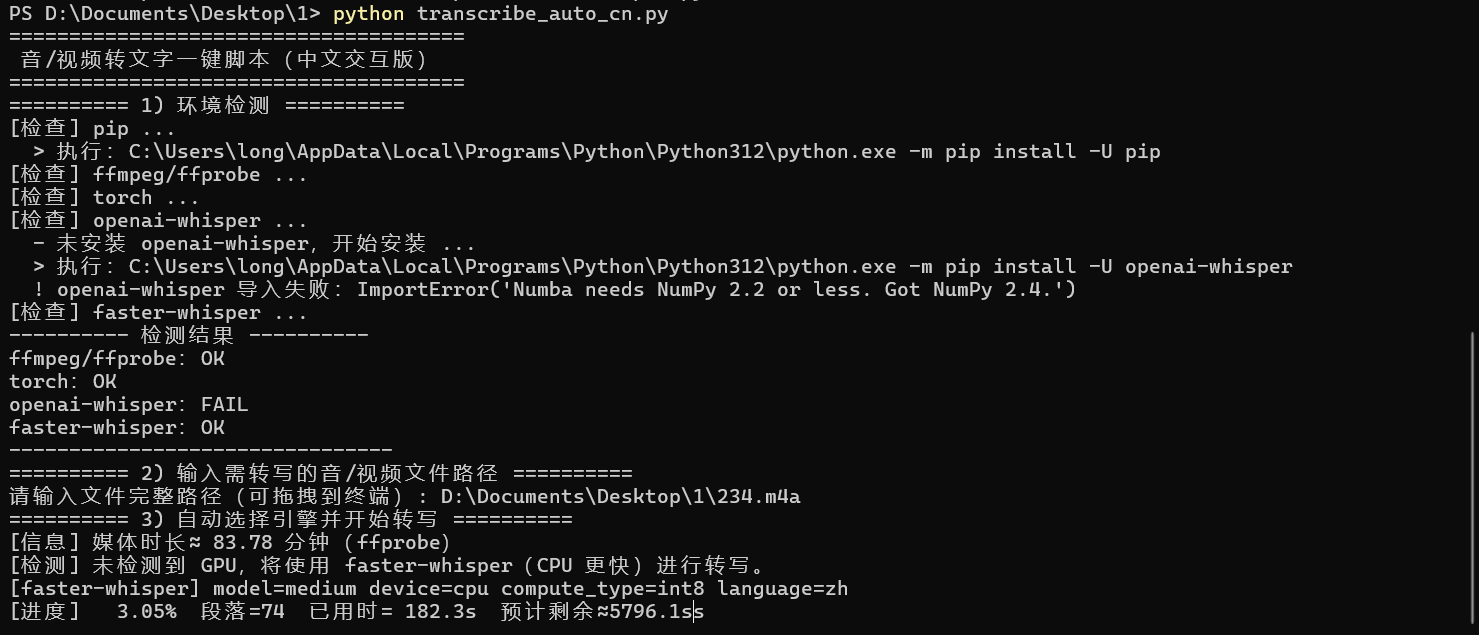
执行示例:
两个模型测试总结
基于已有硬件环境
OpenAI Whisper
OpenAI Whisper 在 GPU 环境下表现非常优秀。 如果设备支持 CUDA,并启用 fp16 推理,转写速度通常可以明显快于实时播放,尤其在中大型模型(medium / large)下优势更加明显。
但在纯 CPU 环境下,情况就完全不同了。
由于原版 Whisper 主要针对 GPU 推理优化,在没有显卡加速的情况下,计算开销较大。 实际测试下来,83 分钟左右的音频,在 CPU 环境下处理时间大约在 3 倍左右。
也就是说:
音频时长 1 小时,处理时间可能接近 3 小时。 实时倍率(RTF)约在 3.0 左右。
这种速度并非不可接受,但对于长音频批量处理来说,时间成本会明显上升。
因此,原版 Whisper 更适合:
- 有独立显卡的设备
- 对模型精度要求较高
- 允许使用较大模型的场景
faster-whisper
faster-whisper 是基于 CTranslate2 优化实现的高性能版本。
与原版不同的是,它在设计上更注重推理效率,尤其是对 CPU 的优化非常明显。
即便在没有 GPU 的情况下,使用 int8 量化推理,速度也能达到接近实时。
测试结果显示:
83 分钟音频的处理时间约等于 83 分钟左右, 音频时长与处理时长基本接近 1:1。
换算成实时倍率(RTF),大约在 1.0 左右。
这意味着:
播放 1 小时音频,处理时间也在 1 小时上下。
对于没有显卡的普通设备来说,这已经是非常可用的效率。
同时,faster-whisper 依然支持 GPU 加速,只是“GPU 不是必须条件”。
因此它更适合:
- 纯 CPU 环境
- 长音频批量处理
- 自动化流程部署
写在最后
音频转文字这件事,本质上不是技术问题,而是效率问题。
如果你只是偶尔整理一次会议记录,用在线工具就足够。 如果你长期处理播客、课程、视频素材,本地部署会更可控。
真正值得投入的不是模型参数,而是流程稳定性。
当“声音 → 文字 → 结构 → 文章”成为固定流程, 内容生产就从灵感驱动,变成系统驱动。
机器负责听。 人负责判断。
而判断,才是内容创作者真正的价值。
最后的最后,如果你不知道怎么下载一个播客音频,可以装一下这个插件: