所感 · 2026-09-26
OpenClaw(原Clawdbot_Moltbot)一键部署
这三个名字是指的同一个AI工具,只是更新了三次名字(关于改名过程,可参考:https://docs.openclaw.ai/zh-CN/start/lore) ,在还是Clawdbot时就准备写一篇的,只是当时部署还不够简单,另外也没有实践过,很多体验未知。但当前无论在之前介绍的1Panel还是各种云服务供应商,都提供了一键部署方案。
OpenClaw(原Clawdbot/Moltbot)部署与思考
这三个名字是指的同一个AI工具,只是更新了三次名字(关于改名过程,可参考:https://docs.openclaw.ai/zh-CN/start/lore) ,在还是Clawdbot时就准备写一篇的,只是当时部署还不够简单,另外也没有实践过,很多体验未知。但当前无论在之前介绍的1Panel还是各种云服务供应商,都提供了一键部署方案。
本文通过前文介绍过的1Panel进行部署演示,但主要想说明一下这个工具的使用范围及注意事项。
关于OpenClaw
OpenClaw是什么
如果你熟悉 ChatGPT,那可以这样理解:
ChatGPT 是一个“只负责回答你”的 AI OpenClaw 是一个“既能思考、又能动手”的 AI 助手(AI Agent)
它不是一个单纯的聊天工具,而是一个你可以自己部署的 AI 助手平台,核心目标只有一个: 让大模型不只“说”,而是“做”。
OpenClaw能做什么
在实际使用中,OpenClaw 的能力通常体现在三类场景:
第一类:消息入口统一 你可以通过企业微信、钉钉、Telegram、WhatsApp、Slack 等平台和它对话,不需要再打开一个 AI 网页。
第二类:执行任务而非只给答案 比如:
- 整理资料并输出结构化文档
- 根据指令自动写代码、改代码、跑脚本
- 读取网页、提取信息、生成总结
- 按流程完成多步任务(而不是一次性回答)
第三类:技能扩展(Skills) 你可以给它“装技能”,让它学会新能力,比如浏览网页、操作文件、调用 API 等。
一句话总结: 它更像一个能接触真实世界的“AI 助理”,而不是一个只活在聊天框里的模型。
它和以往 AI 工具最大的不同在哪?
很多人误以为 OpenClaw 火,是因为“模型更聪明”,其实不是。
真正的变化在于产品形态。
1️⃣ 从“聊天”到“代理(Agent)”
传统 AI 工具:
你问一句 → 它答一句 → 结束
OpenClaw 这类 Agent:
它会先理解任务 → 拆分步骤 → 调用工具 → 检查结果 → 必要时重试
虽然效率很高,但同时也意味着成本的增加: 一次指令,背后可能是十几甚至几十次模型调用。
2️⃣ 从“云端封闭”到“自托管可控”
ChatGPT、Claude 这些工具,本质是“黑盒服务”。你不知道它能访问什么,也无法控制它的边界。
OpenClaw 不一样:
- 跑在你自己的服务器或电脑上
- 接哪些平台、给哪些权限,你说了算
- 模型用哪家、用哪个版本,你自己配
这也是它吸引技术人群的重要原因。
3️⃣ 从“回答问题”到“持续工作流”
一旦你给了足够权限, 它就不再只是“响应”,而可能变成“持续工作”的存在。
而这,既是它最强的地方,也是风险和成本的根源。
部署OpenClaw
1Panel一键部署
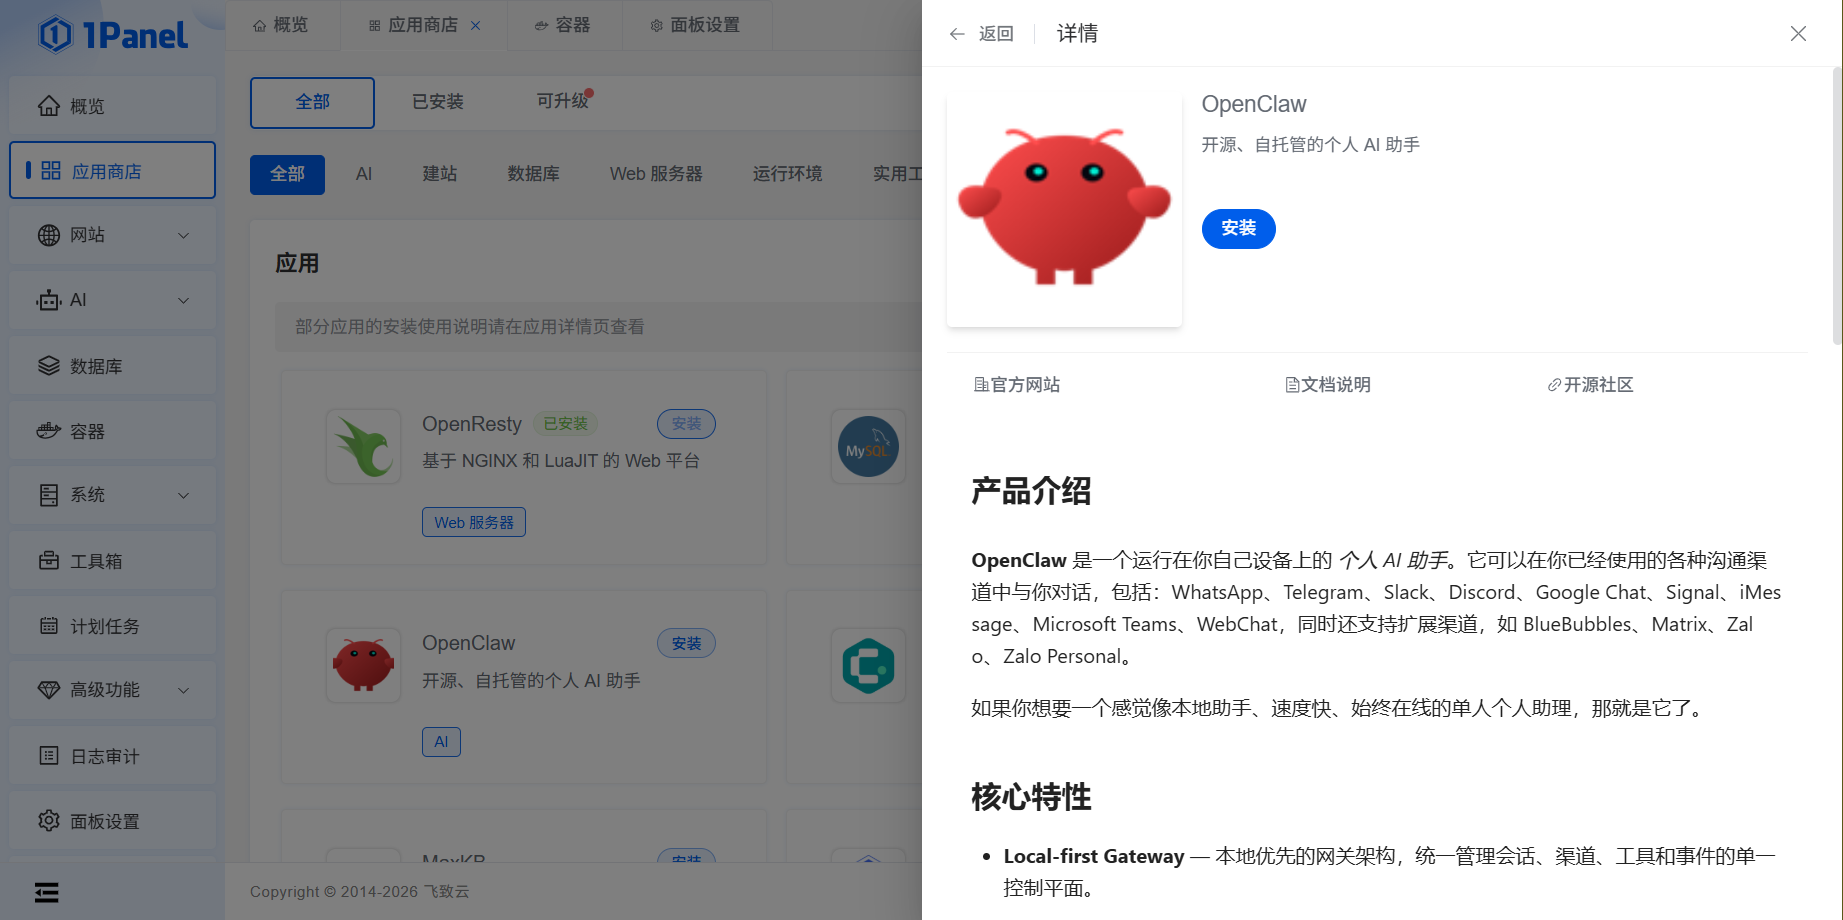
- 应用商店找到后直接安装(如没有,可先刷新商店列表或更新1Panel后再试)
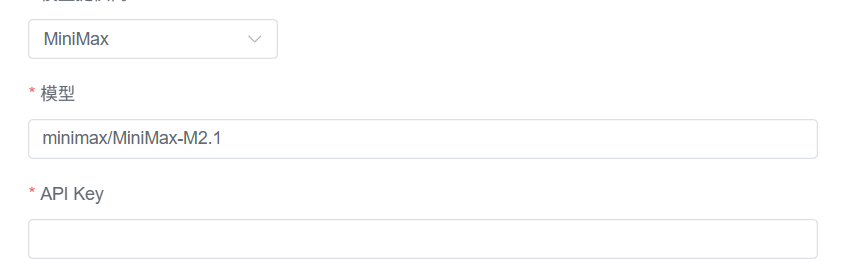
- 部署前需要准备一个大模型的API(根据自己需要选择)
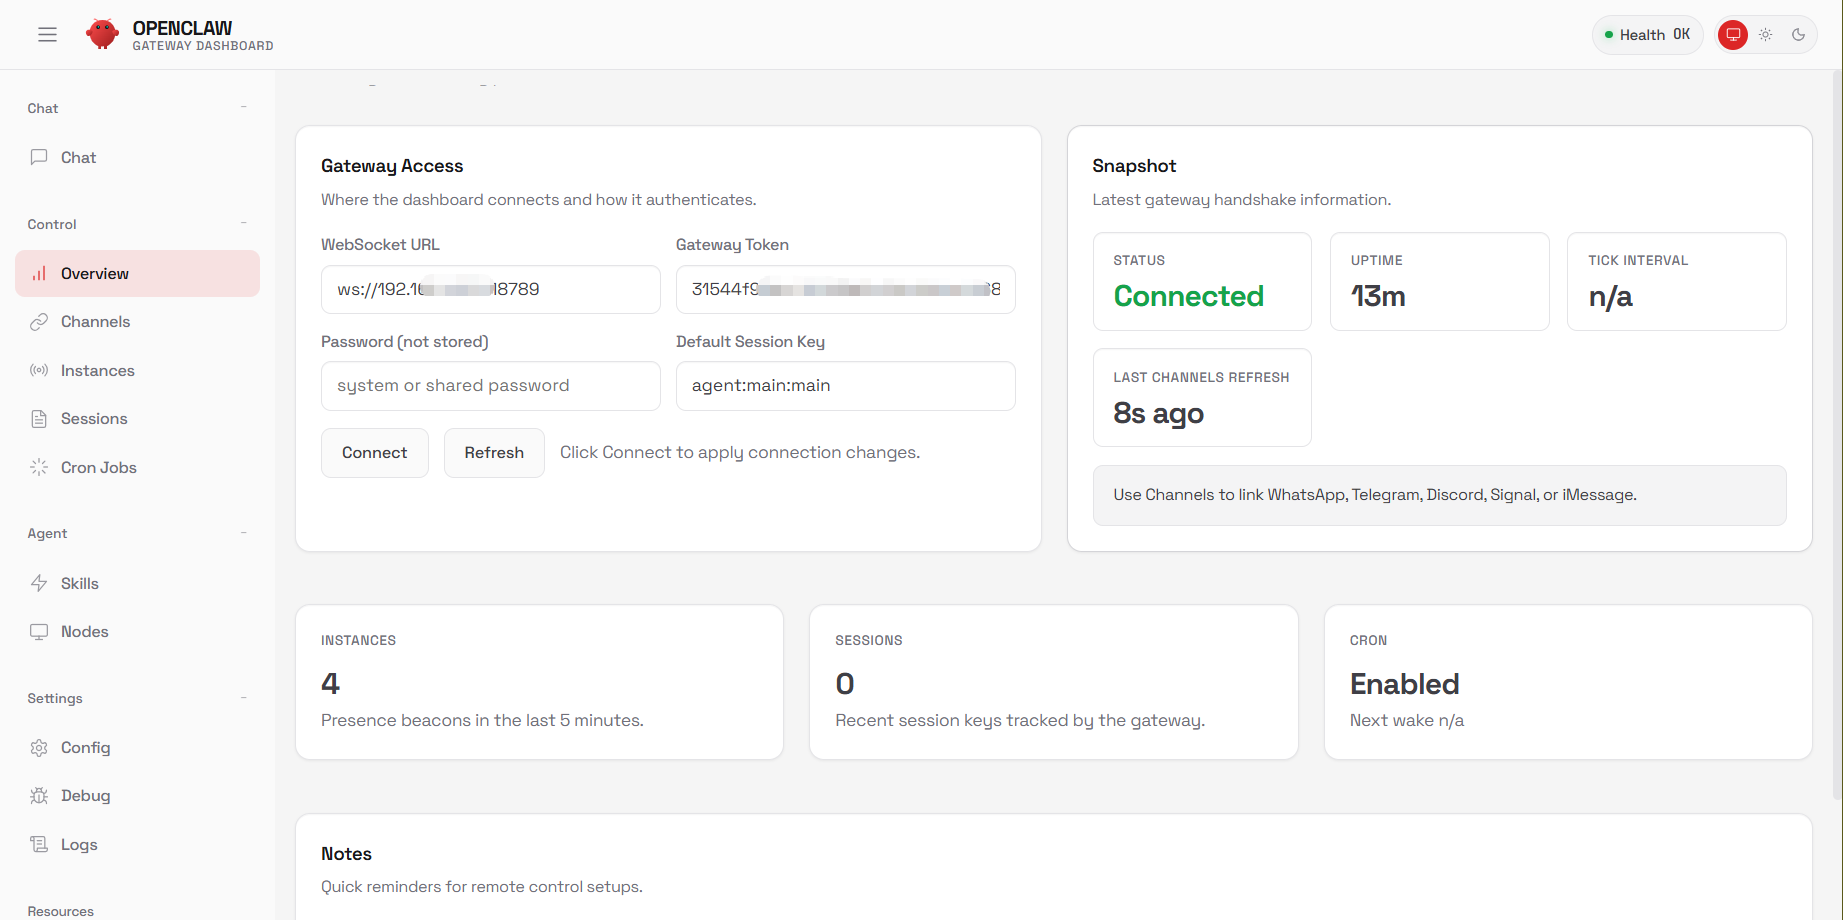
- 安装好后直接访问即可
部署的三个层级
如何安装很简单,详细步骤及QA不在此文赘述,但我想把部署分为三个层级
第一层:最少能跑
只需要三样东西:
- 一台能长期运行的机器(本地 / VPS / 小主机)
- 一个大模型 API Key(OpenAI / Anthropic / Gemini 等)
- 一个消息平台入口(最简单的是 Telegram,国内云服务商提供企微及钉钉快速入口)
目前社区主流方式是 Docker / Docker Compose,基本能做到一条命令启动(1Panel也是这种方式)。
第二层:开始“像个助手”
跑起来只是第一步,要真正能用,还需要:
- 日志与控制面板(不然你不知道它在干什么)
- 权限控制(文件、网络、浏览器、系统命令)
- 精选技能来源(别什么都装)
这一步,OpenClaw 才会从“技术玩具”变成“可用工具”。
第三层:一定要考虑安全
近期已经出现过:
- 恶意 Skills 伪装成工具
- 借助 AI 助手执行命令
- 窃取密钥、环境变量甚至钱包信息的案例
请牢记三条原则:
1️⃣ 用隔离环境跑 Docker / 虚拟机,而不是你日常办公电脑。
2️⃣ 最小权限原则 默认不给文件系统、不给浏览器、不给 SSH。
3️⃣ 把 Skill 当代码审计 安装 Skill ≈ 执行脚本 它不是“插件”,而是“程序”。
如何控制成本
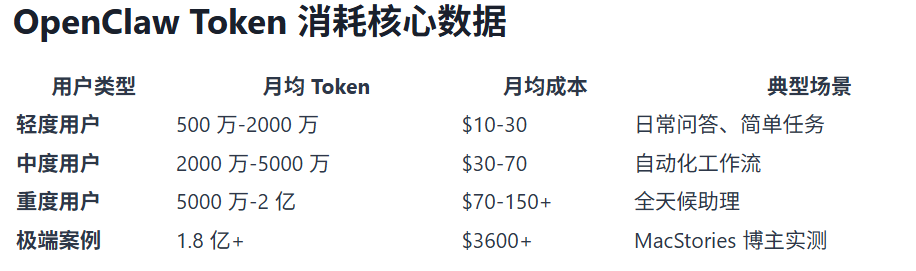
很多第一次用 OpenClaw 的人,都会被账单吓一跳。
1️⃣ 为什么 Token 消耗这么快?
因为它不是“一次问答”,而是:
- 多轮推理
- 多次工具调用
- 多次校验与重试
- 长上下文持续累积
一次看似简单的指令,背后可能是十几次模型调用。
有人在使用高端模型时, 哪怕“正常使用、不折腾”, 每天也可能消耗 十几到二十美元。
这不是 bug,是 Agent 形态的必然结果。
2️⃣ 成本控制的核心思路
一句话: 让贵模型只干“难活”,便宜模型干“杂活”。
可以搜索
模型路由(model routing)关键词进行模型切换配置
具体做法包括:
- 简单总结、格式化、改写 → 用便宜模型
- 复杂推理、重要决策 → 才用高端模型
- 限制最大步骤数 / 重试次数
- 定期压缩上下文(让 AI 自己总结历史)
- 关闭或降低“自动观察 / 主动监控”频率
- 设置 Token 上限与报警机制
- 如果有条件,尽量用本地模型
建议与看法
- 不要用主力账号、主力机器直接跑
- 不要随便安装未知来源的 Skills
- 不要让它自动操作高风险资产(尤其是金融/钱包/账号)
- 不要忽视 API 计费与使用条款
OpenClaw 很强,但它本质上是: 一个把 AI 接入现实世界的自动化入口
OpenClaw 并不是“更聪明的 AI”, 而是“能调用工具干活的AI”。
它代表的不是聊天工具的进化, 而是 AI Agent 时代的雏形。
它值得尝试、值得研究, 但绝不适合在“没想清楚边界”的情况下, 随意给权限、随意跑生产环境。
当 AI 开始替你“做事”, 你就必须像管理一个新人同事一样, 去管理它的权限、成本和风险。